Arrêtez de vous tromper de LLM
Je comprends la réaction.
À ce stade, tout le monde a déjà vu passer trop de comparatifs. Trop de tableaux. Trop de classements bricolés pour servir un titre.
Ici, ce n’est pas ça.
Pas de concours inutile pour décider quel LLM est “le plus intelligent”, “le moins cher” ou “le plus humain”.
Parce que, dans la pratique, tout cela passe à côté de la seule question qui compte :
Faire le travail. Correctement. Efficacement.
Une autre manière de regarder le problème
Votre frustration est légitime.
Et ce que vous allez lire n’est pas un énième benchmark.
C’est une carte cognitive construite à partir du travail réel.
Pas des promesses.
Pas du marketing.
Des échecs concrets, observés sur le terrain.
Des centaines de cas.
Des équipes réelles.
Des projets qui ont coûté du temps, de l’argent, et parfois de la crédibilité.
Mettre les cartes sur la table
On laisse de côté les classifications approximatives.
On passe à la structure.
24 capacités cognitives identifiées dans des usages professionnels réels.
12 dimensions primitives.
Une matrice.
Puis une rotation factorielle (varimax).
Et là, la structure apparaît.
Pas 10 dimensions.
Pas 7.
Trois.
Trois facteurs cognitifs qui expliquent près de 63 % de la variance.
Et c’est là que tout change.
Ce que les données montrent vraiment
Chaque cas analysé répond à une seule question :
Quelle capacité cognitive a échoué ?
Pas quel modèle.
Pas quelle version.
Pas quel prompt.
La capacité.
Résultat : une liste récurrente de défaillances.
- Lire des documents longs sans dériver
- Synthétiser plusieurs sources simultanément
- Maintenir une interprétation complexe sans simplifier à tort
- Modéliser un état émotionnel
- Vérifier sa propre réponse
- Planifier une séquence longue et corriger en cours de route
Et d’autres.
24 primitives au total.
Puis la réduction.

Trois axes. Pas plus.
Trois dimensions indépendantes émergent.
C’est la clé.
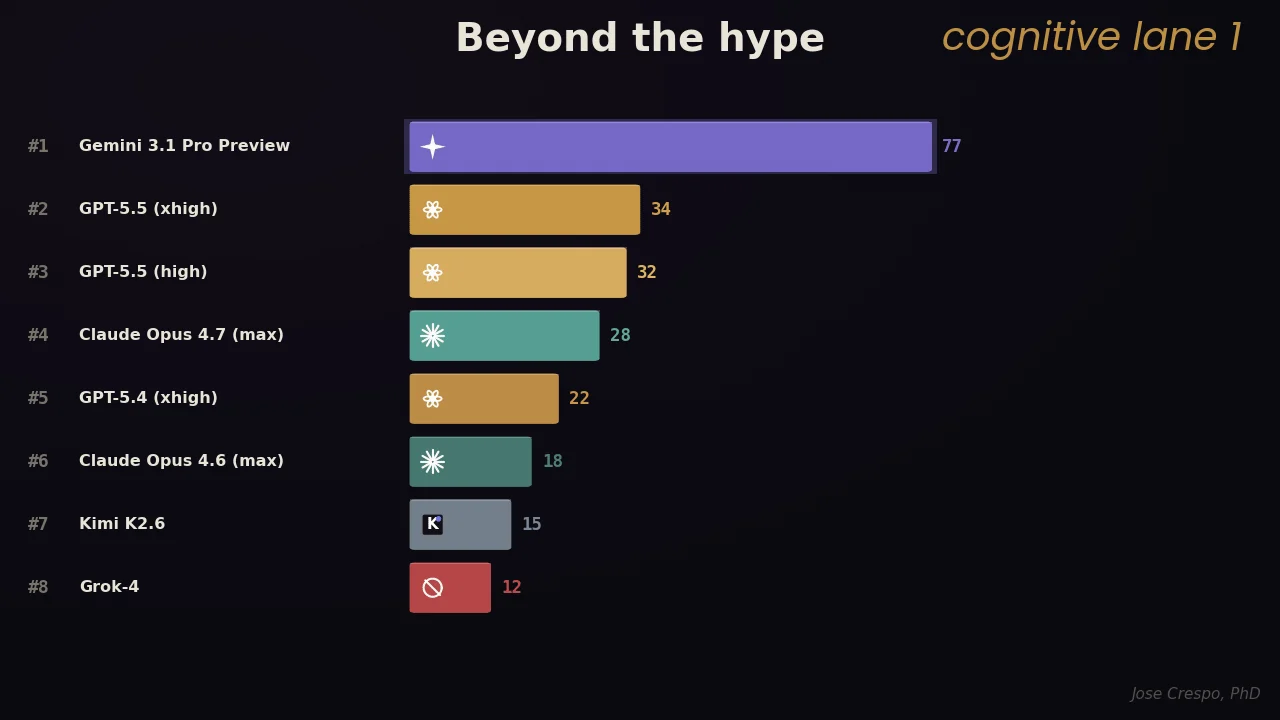
Chaque modèle est optimisé pour une de ces “voies cognitives”.
Chaque tâche professionnelle tire vers l’une d’elles.
Quand ça ne correspond pas, le coût apparaît.
Temps perdu.
Erreurs.
Rework.
Et ce n’est pas marginal.
Le problème que personne ne veut poser clairement
Il reste 37 % de variance non expliquée.
Et elle pointe vers une fracture bien connue :
Visuel vs texte.
- Extraction depuis des graphiques
- Lecture de PDF multi-colonnes
- Interprétation de schémas
D’un côté.
- Raisonnement textuel pur
- Analyse logique
- synthèse narrative
De l’autre.
Aucun modèle actuel ne traverse cette frontière de manière fiable.
Ce n’est pas un problème de puissance de calcul.
C’est un problème de géométrie.
Et ajouter des GPU ne change pas une géométrie.
Là où vous prenez un risque réel
Certaines tâches restent structurellement fragiles :
- Graphiques avec axes implicites
- PDF scannés en colonnes
- Diagrammes directionnels
- Raisonnements circulaires longs
- Suivi de nombreuses entités
- Comptage fiable dans des images
- Reconnaissance de l’incertitude
- Précision sur des faits rares
Envoyez ça à un LLM.
Faites confiance au résultat.
Livrez.
C’est la façon la plus rapide de dégrader votre travail.
Et pourtant, le levier est immense
Une fois ces limites intégrées, le potentiel devient réel.
Mais à une condition :
Arrêter de chercher le meilleur modèle.
Et commencer à poser la bonne question :
De quelle capacité cognitive cette tâche a-t-elle besoin ?
Chaque “voie” correspond à un type de travail :
- Intégration d’information
- Abstraction structurelle
- Exécution procédurale
Chaque modèle excelle dans une seule.
Presque jamais dans les trois.
Pourquoi les benchmarks vous induisent en erreur
Les classements actuels masquent cette réalité.
Ils agrègent tout.
Ils lissent les différences.
Mais en pratique :
Un modèle dominant sur une dimension est souvent moyen sur les autres.
Ce n’est pas un défaut.
C’est une conséquence directe de l’architecture.
Le coût caché que peu calculent
Utiliser le mauvais modèle n’est pas neutre.
C’est un multiplicateur de temps.
Entre 1.1x et 3.1x selon les cas.
Pourquoi ?
Parce que vous ne faites pas confiance à la première réponse.
Vous relisez.
Vous testez.
Vous relancez.
Encore et encore.
Ce que vous payez, ce ne sont pas les réponses.
Ce sont les cycles de vérification.
Et pour les problèmes réels, complexes
Un seul modèle ne suffit pas.
Presque jamais.
Les tâches importantes sont composées :
- Analyse
- Décision
- Exécution
- Vérification
Chacune mobilise une capacité différente.
Forcer tout cela dans un seul modèle crée les échecs que vous observez.
Router chaque étape vers le bon “axe cognitif” change la donne.
Gain observé : x2.3 à x2.5 sur des workflows réels.
Pas parce qu’un modèle devient meilleur.
Mais parce que chaque étape est enfin traitée correctement.
En résumé
Arrêtez de chercher le meilleur LLM.
Identifiez la nature cognitive de votre tâche.
Choisissez le modèle aligné avec cette dimension.
Et composez si nécessaire.
C’est tout.