


1. En une phrase (Définitions simples)
- IA (Intelligence Artificielle "Faible" ou "Étroite") : Un programme conçu pour accomplir une tâche précise (même de façon surhumaine), mais incapable de sortir de son domaine.
- IAG (Intelligence Artificielle Générale) : Une machine hypothétique capable d’apprendre, de comprendre et d’exécuter n'importe quelle tâche intellectuelle au moins aussi bien qu'un être humain.
2. Le Modèle Mental : Spécialiste vs Cerveau Universel
       [ IA Étroite / Actuelle ]                     [ IAG / Futur ]
  ┌─────────────────────────────────┐        ┌─────────────────────────────┐
  │  Tâche A ──► Maîtrise parfaite  │        │ Apprend spontanément        │
  │  Tâche B ──► Échec total        │   VS   │ S'adapte à l'inconnu        │
  │  (Besoin de ré-entraînement)    │        │ Transfère ses compétences   │
  └─────────────────────────────────┘        └─────────────────────────────┘
          "Calculatrice géante"                    "Stagiaire humain ultime"
3. Tableau Comparatif Rapide
| Critère | IA Spécialisée (Narrow AI) | IAG (AGI) |
|---|---|---|
| Statut | Existe aujourd'hui (partout) | Théorique (n'existe pas encore) |
| Périmètre | Limité à un domaine précis | Polyvalent et universel |
| Adaptabilité | Nulle hors entraînement | Auto-apprentissage face à l'imprévu |
| Raisonnement | Reconnaissance de motifs statistiques | Vrai bon sens, logique et abstraction |
| Conscience | Aucune (juste du code et des maths) | Sujet de débat (non requis pour agir) |
4. 4 Exemples Concrets du Monde Réel
- ChatGPT / Claude (IA) : Modèle de langage puissant, mais ne peut pas piloter une voiture, faire une découverte de physique sans données, ni comprendre le monde réel.
- AlphaGo / Stockfish (IA) : Bat n'importe quel humain aux échecs ou au Go, mais incapable de jouer au morpion sans réécriture de son code.
- Pilote automatique Tesla (IA) : Vision par ordinateur de pointe pour la route, mais incapable de traduire un texte en espagnol.
- Le Chercheur Virtuel Autonome (Scénario IAG) : Un système qui lit toute la littérature médicale, formule de nouvelles hypothèses, conçoit des expériences et résout le cancer de façon autonome.
5. Pièges et Confusions Fréquentes à Éviter
- ⚠️ IA Générative ≠ IA Générale : Ce n’est pas parce qu’une IA produit du texte, du code et des images (générative) qu’elle a du bon sens ou une intelligence globale (générale).
- ⚠️ Fluence ≠ Connaissance réelle : Les LLMs manipulent le langage à la perfection, mais n'ont pas de représentation mentale du monde.
- ⚠️ Intelligence ≠ Conscience : L'IAG désigne la capacité de résolution de problèmes, pas le fait de ressentir des émotions (sentience).
6. Checklist "Avant d'en parler ou de l'utiliser"
- [ ] Est-ce que j'analyse un outil existant ? 👉 C'est une IA, jamais une IAG.
- [ ] Le terme "AGI" est-il utilisé dans une annonce ? 👉 Attention au battage marketing (hype).
- [ ] L'outil peut-il résoudre un problème radicalement nouveau sans données préalables ? 👉 Non, c'est une IA étroite.
- [ ] Est-ce que je prends le texte généré pour un "raisonnement humain" ? 👉 Non, ce sont des probabilités de mots.
7. Quiz Éclair (Auto-test en 60 secondes)
- Vrai ou Faux ? GPT-4 est une forme d'IAG car il sait faire du code, de la poésie et des maths.
(Rép : Faux. C’est une IA étroite multi-tâches, sans bon sens réel ni autonomie). - Quelle est la principale caractéristique manquante pour atteindre l'IAG ?
(Rép : La capacité de transférer des connaissances à des contextes totalement inconnus / le raisonnement général). - L'IAG doit-elle obligatoirement être consciente d'elle-même ?
(Rép : Non. Il s'agit d'une métrique d'efficacité cognitive, pas d'état émotionnel). - AlphaFold (prédiction de protéines) est-il une IA ou une IAG ?
(Rép : Une IA spécialisée). - Quel acronyme utilise-t-on en anglais pour désigner l'IAG ?
(Rép : AGI - Artificial General Intelligence).
1. Définition Simple
Un LLM (Large Language Model) est un moteur statistique d'association de motifs (patterns). Il ne « pense » pas et ne consulte pas de base de données : il prédit mathématiquement le prochain jeton (token) le plus probable en fonction du contexte qu'on lui donne.
Modèle mental : Un système d'autocomplétion surpuissant, entraîné sur une immense partie d'Internet.
2. Concepts Clés & Cycle de Traitement
[ Texte brut ] ➔ 1. Tokenisation ➔ 2. Embeddings ➔ 3. Couches Transformer (Attention) ➔ [ Probabilités ] ➔ Jeton suivant- Tokenisation : Découpage du texte en petits fragments (~4 caractères ou ¾ de mot).
- Exemple :
"Apprentissage"$\rightarrow$["Appren", "tissage"].
- Exemple :
- Plongements (Embeddings) : Conversion des jetons en vecteurs de nombres. Les mots aux sens proches se regroupent géométriquement (
"roi"-"homme"+"femme"$\approx$"reine"). - Mécanisme d'Attention (Self-Attention) : Le cœur du système. Il pondère l'importance des autres mots du texte pour comprendre le contexte immédiat.
- Exemple : Dans "La banque de données" vs "La banque près du fleuve", l'attention oriente le sens du mot "banque".
- Pipeline d'Entraînement :
- Pré-entraînement (Pre-training) : Lecture de milliards de textes bruts pour assimiler la grammaire, la logique et des connaissances générales (coûteux, non supervisé).
- Ajustement fin (Fine-Tuning / SFT) : Entraînement sur des dialogues ciblés (questions/réponses) pour adopter la posture d'un assistant.
- Alignement humain (RLHF) : Optimisation par renforcement selon des critères humains pour être utile, inoffensif et précis.
- Paramètres : Les millions ou milliards de « curseurs » numériques internes ajustés lors de l'apprentissage.
3. Schéma Visuel du Cycle de Génération
       PROMPT : "Le ciel est"
                  │
                  ▼
       ┌─────────────────────┐
       │    Tokenisation     │  ➔ ["Le", " ciel", " est"]
       └─────────────────────┘
                  │
                  ▼
       ┌─────────────────────┐
       │   Vecteurs d'entrée │  ➔ Conversion en coordonnées mathématiques
       │     (Embeddings)    │
       └─────────────────────┘
                  │
                  ▼
       ┌─────────────────────┐
       │ Blocs Transformer   │  ➔ L'Attention croise les contextes
       │ (Répétés N fois)    │    ("ciel" + "est" ➔ appelle une couleur)
       └─────────────────────┘
                  │
                  ▼
       ┌─────────────────────┐     bleu   (72 %)
       │ Moteur Prédictif    │  ➔  gris   (14 %)
       │   (Probabilités)    │     sombre (8 %)
       └─────────────────────┘
                  │
                  ▼
       Sélection : "bleu" ➔ Ajouté au prompt ➔ Répète la boucle pour le mot suivant
4. Exemples Concrets en Pratique
| Cas concret | Contexte / Entrée | Ce que fait le modèle sous le capot |
|---|---|---|
| Désambiguïsation | « L'avocat a plaidé au tribunal puis a mangé son déjeuner. » | L'attention associe le premier avocat à la justice et non au fruit en reliant le mot à « plaidé » et « tribunal ». |
| Réglage de la Température | Temp = 0.0 vs Temp = 0.8 |
0.0 : Choisit systématiquement le jeton n°1 (bleu). Rigide, logique. 0.8 : Sélectionne parfois des jetons moins probables (azur, nuageux). Créatif. |
| Apprentissage en contexte (Few-Shot) | Fournir 2 exemples de conversion avant de demander la 3ème. | Le modèle adapte ses poids d'attention en temps réel pour reproduire le format, sans réentraînement. |
5. Pièges et Idées Reçues
- ✖ « Le modèle consulte Internet ou une base interne. » $\rightarrow$ ✔ Il génère du texte par reconstitution probabiliste depuis ses poids (sauf si couplé à un outil de recherche web ou un système RAG).
- ✖ « Il comprend le monde comme un être humain. » $\rightarrow$ ✔ Il manipule des corrélations de formes linguistiques, sans conscience ni réelle compréhension sémantique.
- ✖ « L'hallucination est une panne système. » $\rightarrow$ ✔ C'est le comportement normal de génération : le modèle ne fait pas la différence entre un fait avéré et une suite de mots plausible.
- ✖ « 1 Jeton (Token) = 1 Mot. » $\rightarrow$ ✔ En moyenne, 1 000 mots correspondent à environ 1 300 ou 1 400 jetons (la ponctuation, les majuscules et les espaces comptent).
6. Checklist « Avant Utilisation »
- [ ] Rôle assigné : Avez-vous précisé le rôle ou l'expertise attendue (« Agis comme un ingénieur... ») ?
- [ ] Contexte fourni : Lui avez-vous injecté les données sources nécessaires pour limiter l'invention de faits ?
- [ ] Température calibrée : Basse (0.0 à 0.3) pour du code, de la logique ou des synthèses ; Haute (0.7 à 1.0) pour du remue-méninges ou de la fiction.
- [ ] Capacité de contexte surveillée : Le prompt et la réponse attendue respectent-ils la limite maximale de tokens du modèle ?
- [ ] Contrôle critique : Avez-vous vérifié manuellement le code généré, les calculs mathématiques ou les sources mentionnées ?
7. Auto-Test Flash (5 Questions)
- Q : Quel est l'objectif fondamental d'un LLM lors de la génération ?
R : Prédire le prochain jeton (token) le plus probable. - Q : Quel mécanisme interne permet d'évaluer les liens entre différents mots d'une même phrase ?
R : L'Attention (ou Self-Attention). - Q : Comment nomme-t-on le fait qu'un LLM produise une fausse information avec une totale assurance ?
R : Une hallucination. - Q : Quelle étape d'entraînement enseigne au modèle à répondre sous forme d'assistant poli et sécurisé ?
R : L'alignement / le réglage fin (Fine-Tuning / RLHF). - Q : Quel paramètre faut-il réduire pour obtenir des réponses plus prévisibles et factuelles ?
R : La température.
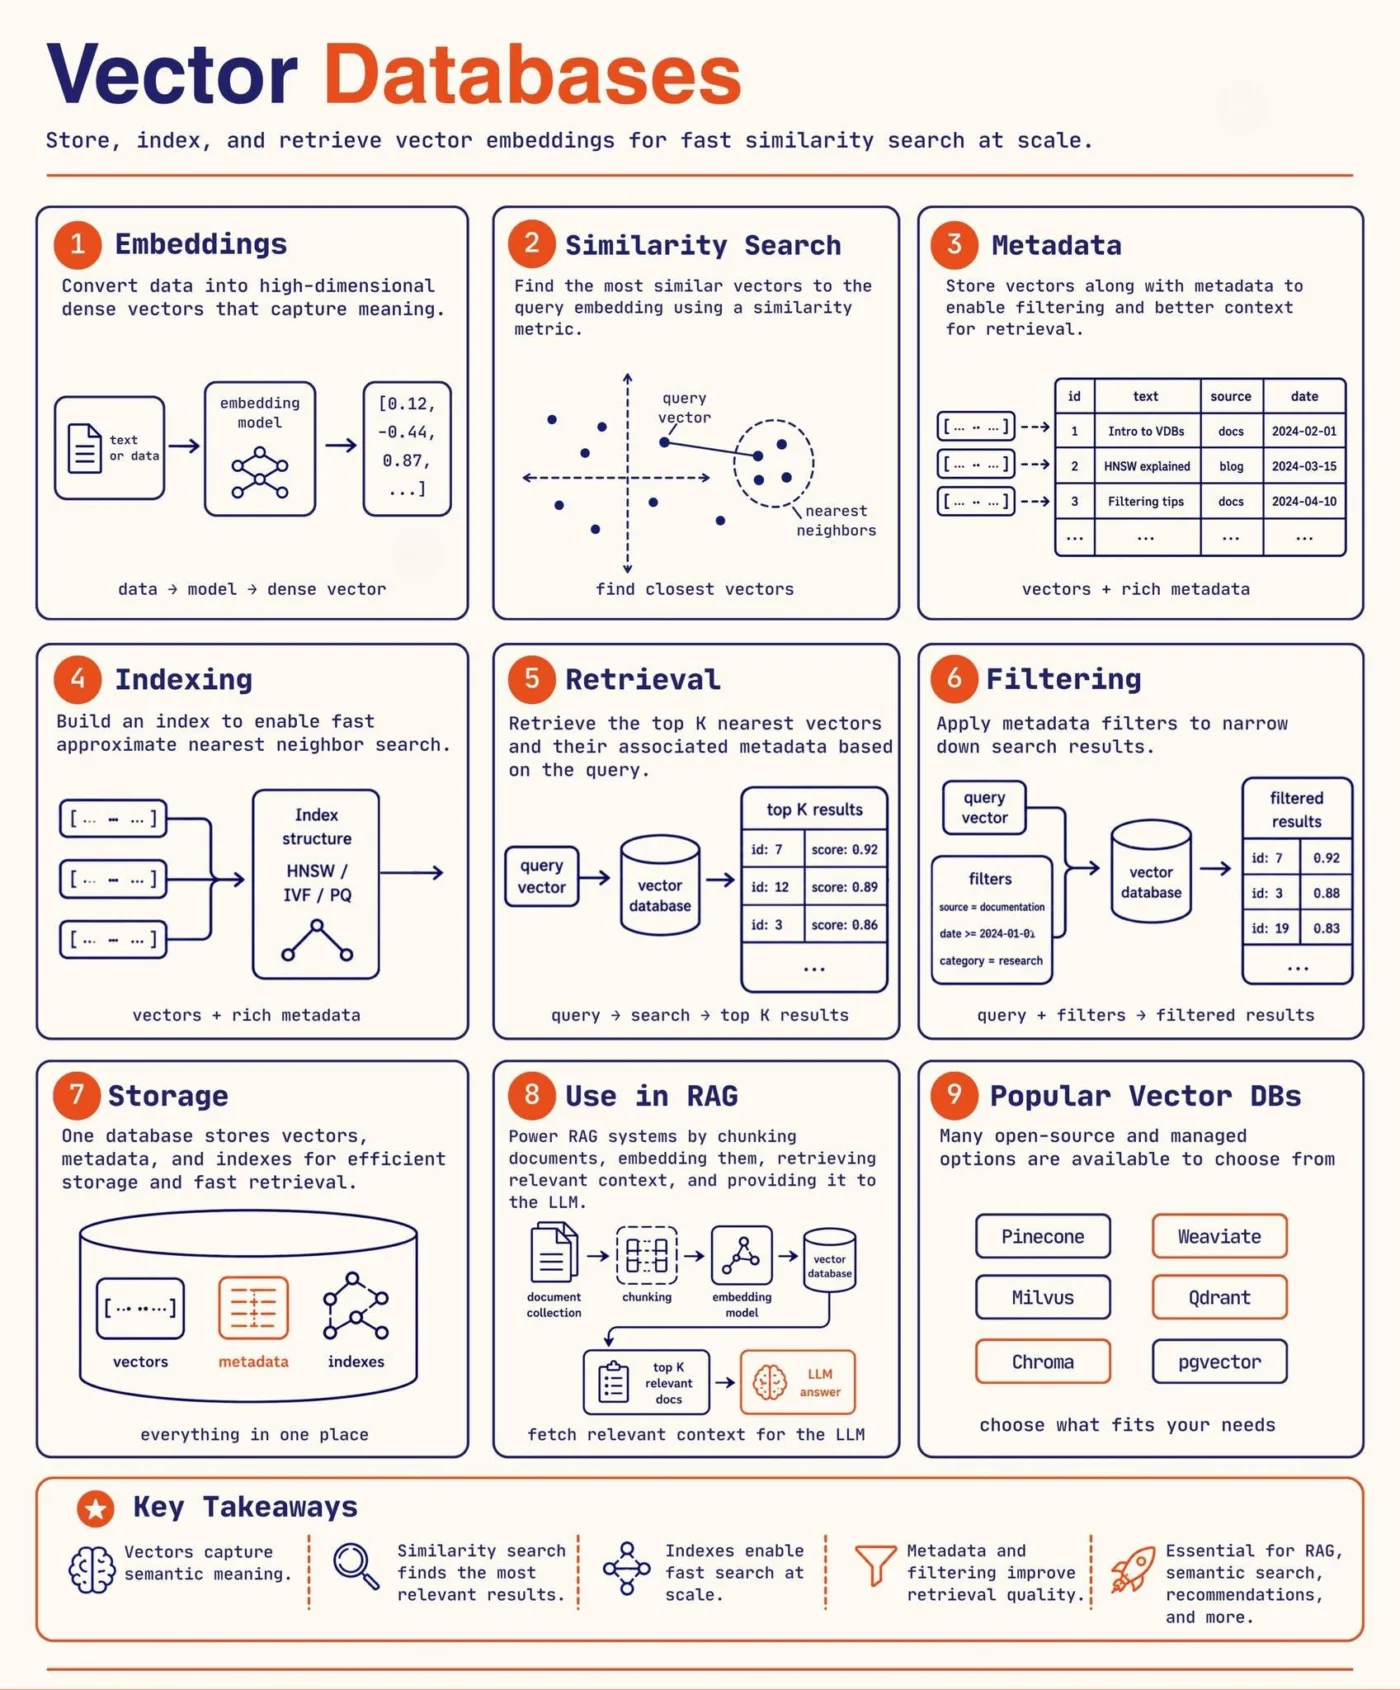
On parle beaucoup du LLM. Rarement de ce qui lui fournit la bonne information au bon moment.
Voici comment ça fonctionne, étape par étape :
🧠 Embeddings
Votre texte devient un vecteur dense qui capture le sens, pas juste les mots.
🔍 Recherche par similarité
La question est vectorisée à son tour, puis comparée aux vecteurs les plus proches.
🏷️ Métadonnées
Source, date, catégorie : ce qui rend un résultat réellement exploitable, pas juste "proche".
⚡ Indexation
Des structures comme HNSW, IVF ou PQ gardent la recherche rapide, même sur des millions de vecteurs.
🎯 Filtrage
Vous combinez recherche sémantique et critères stricts : source = documentation, date ≥ 2024.
📦 Stockage
Vecteurs, métadonnées et index cohabitent pour que la récupération reste efficace.
🔗 Application au RAG
Découper les documents → les vectoriser → récupérer les meilleurs extraits → les transmettre au modèle.
🛠️ Options courantes
Pinecone, Weaviate, Milvus, Qdrant, Chroma, pgvector — le choix dépend de l'échelle, du budget, du filtrage.
Cette couche compte autant que le modèle lui-même.
C'est l'entrée en application de l'article 50 du règlement européen sur l'IA. Ce que ça change, en bref :
L'essentiel en 3 points
- Obligation légale : tout contenu IA (texte, image, audio, vidéo) doit être marqué dans un format lisible par machine.
- Amendes : jusqu'à 15 M€ ou 3 % du chiffre d'affaires mondial.
- Signataires : Anthropic, Google, OpenAI et Meta ont tous adopté le code de bonnes pratiques européen.
Comment ça marche
Texte Une signature statistique dans le choix des mots. Invisible à l'œil, détectable par des outils spécialisés, survit au copier-coller.
Image et vidéo La marque est intégrée aux pixels (ex. SynthID de Google). Elle résiste au recadrage, au redimensionnement et à la compression.
Fichiers Le standard C2PA attache un historique de provenance signé : quel outil, à quel moment.
Où en sont les acteurs majeurs
Acteur Ce qui a changé Anthropic (Claude) Marquage invisible du texte sur tous les modèles lancés depuis le 2 août, appliqué mondialement Google (Gemini) Marquage texte et image via SynthID X, YouTube, Pinterest Mentions automatiques "Made with AI" sur le contenu détectéLes limites à connaître
Le marquage n'est pas infaillible :
- Une réécriture profonde ou une traduction peut affaiblir la marque textuelle
- Une capture d'écran efface souvent les métadonnées de fichier
- Les marques dans les pixels tiennent mieux, mais rien n'est garanti à 100 %
À noter : retirer délibérément une marque est une infraction au règlement.
Ce que ça change pour vous
Le sujet dépasse la conformité juridique. Il touche la confiance accordée à vos contenus et vos communications.
Les entreprises qui comprennent tôt ces mécanismes gardent la main sur leur usage de l'IA, au lieu de le subir.
La majorité des utilisateurs de l'IA générative en exploitent une fraction.
Ils ouvrent un onglet, posent une question, copient la réponse. C'est l'usage de 2023.
Les applications de bureau agentiques changent la nature de l'outil. Trois capacités s'ajoutent, absentes du navigateur.
- Les outils connectés. L'agent accède au CRM, aux feuilles de calcul, aux outils de gestion de projet. Il ne commente plus vos données, il les traite.
- Les tâches planifiées. Le rapport d'analyse hebdomadaire se déclenche seul. Vous relisez, vous arbitrez.
- Le contrôle de la machine. L'agent ouvre vos fichiers, pilote vos applications, agit dans votre navigateur.
Le levier réel se situe ailleurs. Il tient au contexte que vous accumulez : comptes rendus de réunion, modèles de documents, procédures répétées. Chaque semaine d'usage rend l'outil plus juste. C'est un actif qui se capitalise.
Reste une règle de discipline. Confiez à l'agent les 60 % du milieu. Les 20 % du début relèvent de votre jugement. Les 20 % de la fin relèvent de votre voix. Un agent produit un premier jet, jamais une signature.
C'est précisément ce que nous enseignons. L'IA augmente le professionnel, elle ne le remplace pas. Encore faut-il savoir l'orchestrer.
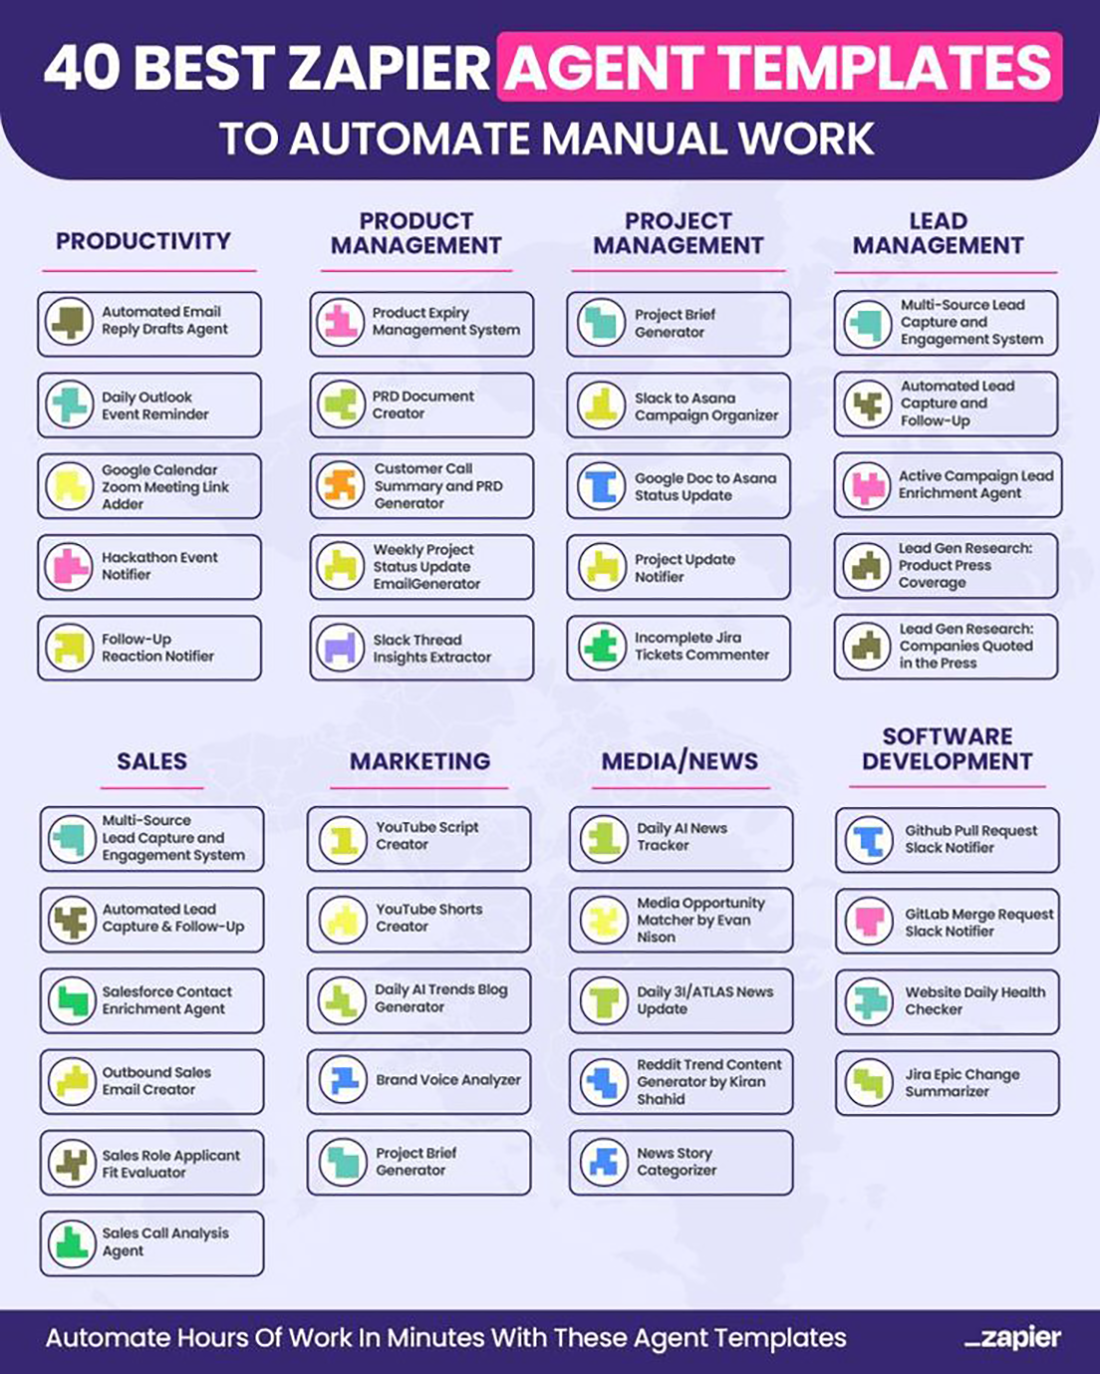
BEST ZAPIER AGENT TEMPLATES TO AUTOMATE MANUAL WORK
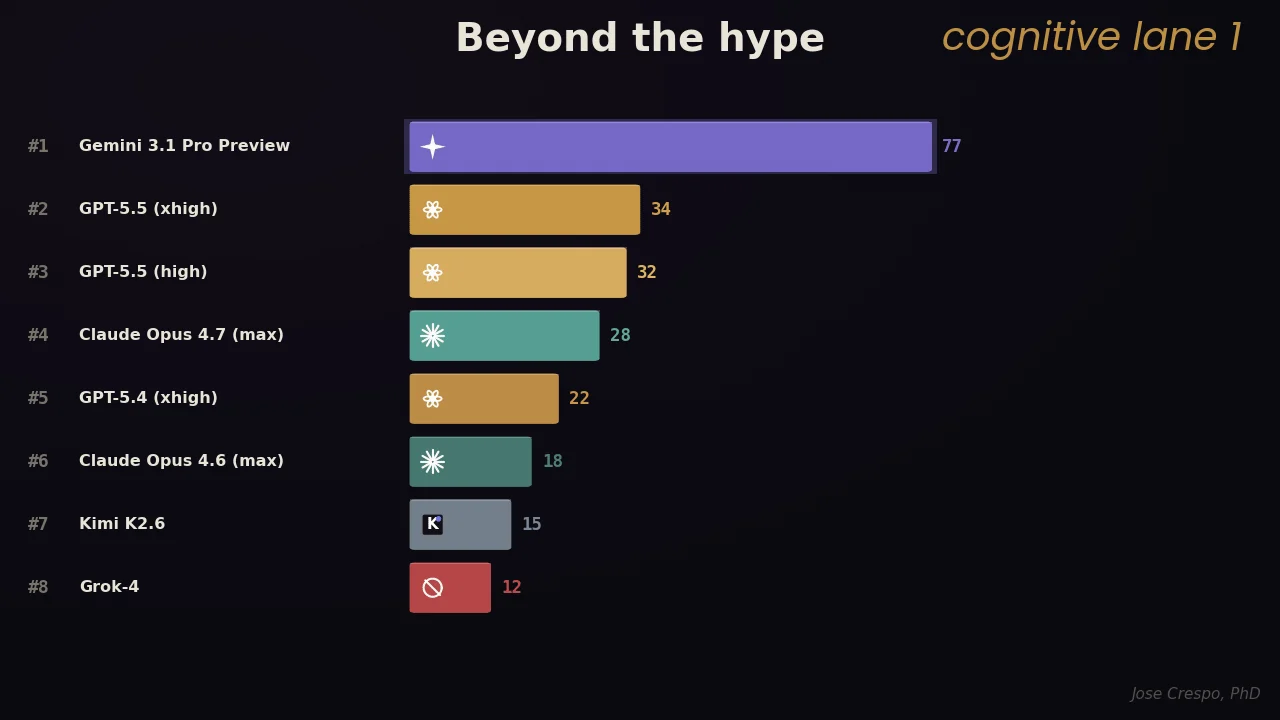
Je comprends la réaction.
À ce stade, tout le monde a déjà vu passer trop de comparatifs. Trop de tableaux. Trop de classements bricolés pour servir un titre.
Ici, ce n’est pas ça.
Pas de concours inutile pour décider quel LLM est “le plus intelligent”, “le moins cher” ou “le plus humain”.
Parce que, dans la pratique, tout cela passe à côté de la seule question qui compte :
Faire le travail. Correctement. Efficacement.
Une autre manière de regarder le problème
Votre frustration est légitime.
Et ce que vous allez lire n’est pas un énième benchmark.
C’est une carte cognitive construite à partir du travail réel.
Pas des promesses.
Pas du marketing.
Des échecs concrets, observés sur le terrain.
Des centaines de cas.
Des équipes réelles.
Des projets qui ont coûté du temps, de l’argent, et parfois de la crédibilité.
Mettre les cartes sur la table
On laisse de côté les classifications approximatives.
On passe à la structure.
24 capacités cognitives identifiées dans des usages professionnels réels.
12 dimensions primitives.
Une matrice.
Puis une rotation factorielle (varimax).
Et là, la structure apparaît.
Pas 10 dimensions.
Pas 7.
Trois.
Trois facteurs cognitifs qui expliquent près de 63 % de la variance.
Et c’est là que tout change.
Ce que les données montrent vraiment
Chaque cas analysé répond à une seule question :
Quelle capacité cognitive a échoué ?
Pas quel modèle.
Pas quelle version.
Pas quel prompt.
La capacité.
Résultat : une liste récurrente de défaillances.
- Lire des documents longs sans dériver
- Synthétiser plusieurs sources simultanément
- Maintenir une interprétation complexe sans simplifier à tort
- Modéliser un état émotionnel
- Vérifier sa propre réponse
- Planifier une séquence longue et corriger en cours de route
Et d’autres.
24 primitives au total.
Puis la réduction.

Trois axes. Pas plus.
Trois dimensions indépendantes émergent.
C’est la clé.
Chaque modèle est optimisé pour une de ces “voies cognitives”.
Chaque tâche professionnelle tire vers l’une d’elles.
Quand ça ne correspond pas, le coût apparaît.
Temps perdu.
Erreurs.
Rework.
Et ce n’est pas marginal.
Le problème que personne ne veut poser clairement
Il reste 37 % de variance non expliquée.
Et elle pointe vers une fracture bien connue :
Visuel vs texte.
- Extraction depuis des graphiques
- Lecture de PDF multi-colonnes
- Interprétation de schémas
D’un côté.
- Raisonnement textuel pur
- Analyse logique
- synthèse narrative
De l’autre.
Aucun modèle actuel ne traverse cette frontière de manière fiable.
Ce n’est pas un problème de puissance de calcul.
C’est un problème de géométrie.
Et ajouter des GPU ne change pas une géométrie.
Là où vous prenez un risque réel
Certaines tâches restent structurellement fragiles :
- Graphiques avec axes implicites
- PDF scannés en colonnes
- Diagrammes directionnels
- Raisonnements circulaires longs
- Suivi de nombreuses entités
- Comptage fiable dans des images
- Reconnaissance de l’incertitude
- Précision sur des faits rares
Envoyez ça à un LLM.
Faites confiance au résultat.
Livrez.
C’est la façon la plus rapide de dégrader votre travail.
Et pourtant, le levier est immense
Une fois ces limites intégrées, le potentiel devient réel.
Mais à une condition :
Arrêter de chercher le meilleur modèle.
Et commencer à poser la bonne question :
De quelle capacité cognitive cette tâche a-t-elle besoin ?
Chaque “voie” correspond à un type de travail :
- Intégration d’information
- Abstraction structurelle
- Exécution procédurale
Chaque modèle excelle dans une seule.
Presque jamais dans les trois.
Pourquoi les benchmarks vous induisent en erreur
Les classements actuels masquent cette réalité.
Ils agrègent tout.
Ils lissent les différences.
Mais en pratique :
Un modèle dominant sur une dimension est souvent moyen sur les autres.
Ce n’est pas un défaut.
C’est une conséquence directe de l’architecture.
Le coût caché que peu calculent
Utiliser le mauvais modèle n’est pas neutre.
C’est un multiplicateur de temps.
Entre 1.1x et 3.1x selon les cas.
Pourquoi ?
Parce que vous ne faites pas confiance à la première réponse.
Vous relisez.
Vous testez.
Vous relancez.
Encore et encore.
Ce que vous payez, ce ne sont pas les réponses.
Ce sont les cycles de vérification.
Et pour les problèmes réels, complexes
Un seul modèle ne suffit pas.
Presque jamais.
Les tâches importantes sont composées :
- Analyse
- Décision
- Exécution
- Vérification
Chacune mobilise une capacité différente.
Forcer tout cela dans un seul modèle crée les échecs que vous observez.
Router chaque étape vers le bon “axe cognitif” change la donne.
Gain observé : x2.3 à x2.5 sur des workflows réels.
Pas parce qu’un modèle devient meilleur.
Mais parce que chaque étape est enfin traitée correctement.
En résumé
Arrêtez de chercher le meilleur LLM.
Identifiez la nature cognitive de votre tâche.
Choisissez le modèle aligné avec cette dimension.
Et composez si nécessaire.
C’est tout.
Vous payez 20 €/mois pour le forfait Pro, 100 € pour le Max ou 200 € pour le Max 20x.
Pourtant, 75 % de cet argent part en fumée. Pas pour vos tâches, mais pour que Claude s'écoute parler. Et vous le laissez faire.
J'ai suivi ma consommation pendant une semaine. La plupart des tokens sont brûlés dans le vide. Voici ce que j'ai changé pour économiser environ 500 € par mois.
Partie 1 - Apprenez à Claude à parler comme un "Caveman" (Homme des cavernes)
Un Claude standard sur une recherche web : ~180 tokens. Il dit : "Je vais vous aider à chercher ça !", puis cherche, explique ce qu'il a trouvé, résume, et demande si vous avez besoin d'autre chose.
Claude Caveman sur la même tâche : ~45 tokens. "Outil utilisé, résultat, moi fini."
- 135 tokens × 20 tâches/jour = 2 700 tokens sauvés quotidiennement.
- Par mois, c'est environ 81 000 tokens que vous ne brûlez plus.
Caveman : une compétence qui réduit les coûts de tokens de 65 à 87 % (1 900+ stars)
Benchmarks réels via l'API :
- Expliquer un bug de re-render React :
1180 → 159 tokens(-87 %) - Fixer un middleware d'auth :
704 → 121 tokens(-83 %) - Pool de connexion PostgreSQL :
2347 → 380 tokens(-84 %) - Moyenne sur 10 tâches : 75 % d'économie.
Python
/plugin marketplace add JuliusBrussee/caveman/plugin install caveman
Trois niveaux d'intensité :

- lite : supprime le blabla, garde la grammaire (pro, sans fioritures).
- full : supprime les articles, phrases fragmentées (mode rustre).
- ultra : compression maximale (style télégraphique, coupe tout).
Conseil : Commencez par lite. Passez en full pour les tâches d'agent où vous ne lisez pas les réponses de toute façon.
Pourquoi ça marche : Claude Caveman ne se justifie pas, il exécute. Il donne le résultat et s'arrête. Pas de "Je serais ravi de vous aider". Zéro gras.

Partie 2 - Arrêtez de perdre 2h chaque matin
Vous commencez à bosser à 8h30 et à 11h, vous avez déjà atteint la limite. Bloqué jusqu'à 13h00. Deux heures mortes en plein milieu de votre journée.
Le secret pour hacker la fenêtre de tir :
L'utilisation de Claude fonctionne sur une fenêtre glissante de 5 heures. Elle s'active dès votre premier message, arrondie à l'heure inférieure.
- Premier message à 8h30 → fenêtre ancrée à 8h00 → court jusqu'à 13h00.
- Limite atteinte à 11h00 → attente jusqu'à 13h00 → 2h de temps mort.
Mais si vous envoyez un simple "salut" via Haiku à 6h15 avant de bosser :
- "Salut" à 6h15 → fenêtre ancrée à 6h00 → court jusqu'à 11h00.
- À 11h00, la fenêtre se réinitialise immédiatement.
- Nouvelle fenêtre : 11h00 - 16h00 → Zéro interruption.

claude-warmup : ancrage automatique de fenêtre
Un job cron via GitHub Actions qui envoie un "salut" à Haiku chaque matin.
Python
# .github/workflows/warmup.yml
on:
  schedule:
    - cron: '15 6 * * 1-5'  # 6h15 en semaine
Ou via les tâches planifiées de Claude :
Python
/schedule "envoyer 'salut' à haiku à 6h15 tous les jours de la semaine"
Partie 3 - Les autres fuites que vous ignorez
Éditez, ne répondez pas
Quand Claude se trompe, on a tendance à écrire : "Non, je voulais dire X". Chaque nouveau message s'empile sur les précédents. Claude relit tout l'historique à chaque fois.
- 5 messages : 7,5k tokens
- 20 messages : 105k tokens
- 30 messages : 232k tokens (le message 30 coûte 31x plus cher que le premier).
- Solution : Cliquez sur Modifier (Edit) sur votre message d'origine, corrigez-le et régénérez. Le mauvais échange est remplacé, pas empilé.

Groupez vos questions
Trois prompts séparés = trois chargements complets du contexte. Un seul prompt avec trois questions = un seul chargement.
- Au lieu de : "Résume l'article" → attend → "Fais une liste" → attend.
- Écrivez : "Résume cet article, liste les points clés et propose un titre."
Utilisez les Projets (Projects) pour les fichiers
Uploader le même PDF dans plusieurs chats ? Claude le re-tokenise à chaque fois.
- PDF de 100 pages = ~75 000 tokens.
- Uploadé 5 fois = 375 000 tokens brûlés.
- Dans Projects : Uploadé 1 fois = 75 000 tokens. Le reste est gratuit car mis en cache.
Enregistrez votre contexte dans "Memory"
Chaque nouveau chat sans contexte enregistré coûte 3 à 5 messages de configuration.
- Allez dans Paramètres -> Memory. Sauvegardez votre rôle et vos préférences (ex: "Je suis dev, réponses courtes, toujours en TypeScript"). Claude les applique partout automatiquement. Zéro token de configuration.
Aide-mémoire (Cheat Sheet)
- TUEUR DE TOKENS #1 : Réponses bavardes → FIX : Skill Caveman (-80%).
- TUEUR DE TOKENS #2 : Fenêtre qui démarre trop tard → FIX : claude-warmup à 6h00.
- TUEUR DE TOKENS #3 : Répondre au lieu d'éditer → FIX : Bouton Edit + Régénérer.
- TUEUR DE TOKENS #4 : Questions isolées → FIX : Groupage (Batching).
- TUEUR DE TOKENS #5 : Re-upload de fichiers → FIX : Utiliser "Projects".
Note finale : Depuis mars 2026, les heures de pointe (14h - 20h en Europe / 5h - 11h Pacifique) saturent les limites plus vite. Gardez les tâches lourdes pour le soir ou le week-end.
Claude ne compte pas vos messages. Il compte vos tokens. Arrêtez de lui donner des raisons d'en consommer.