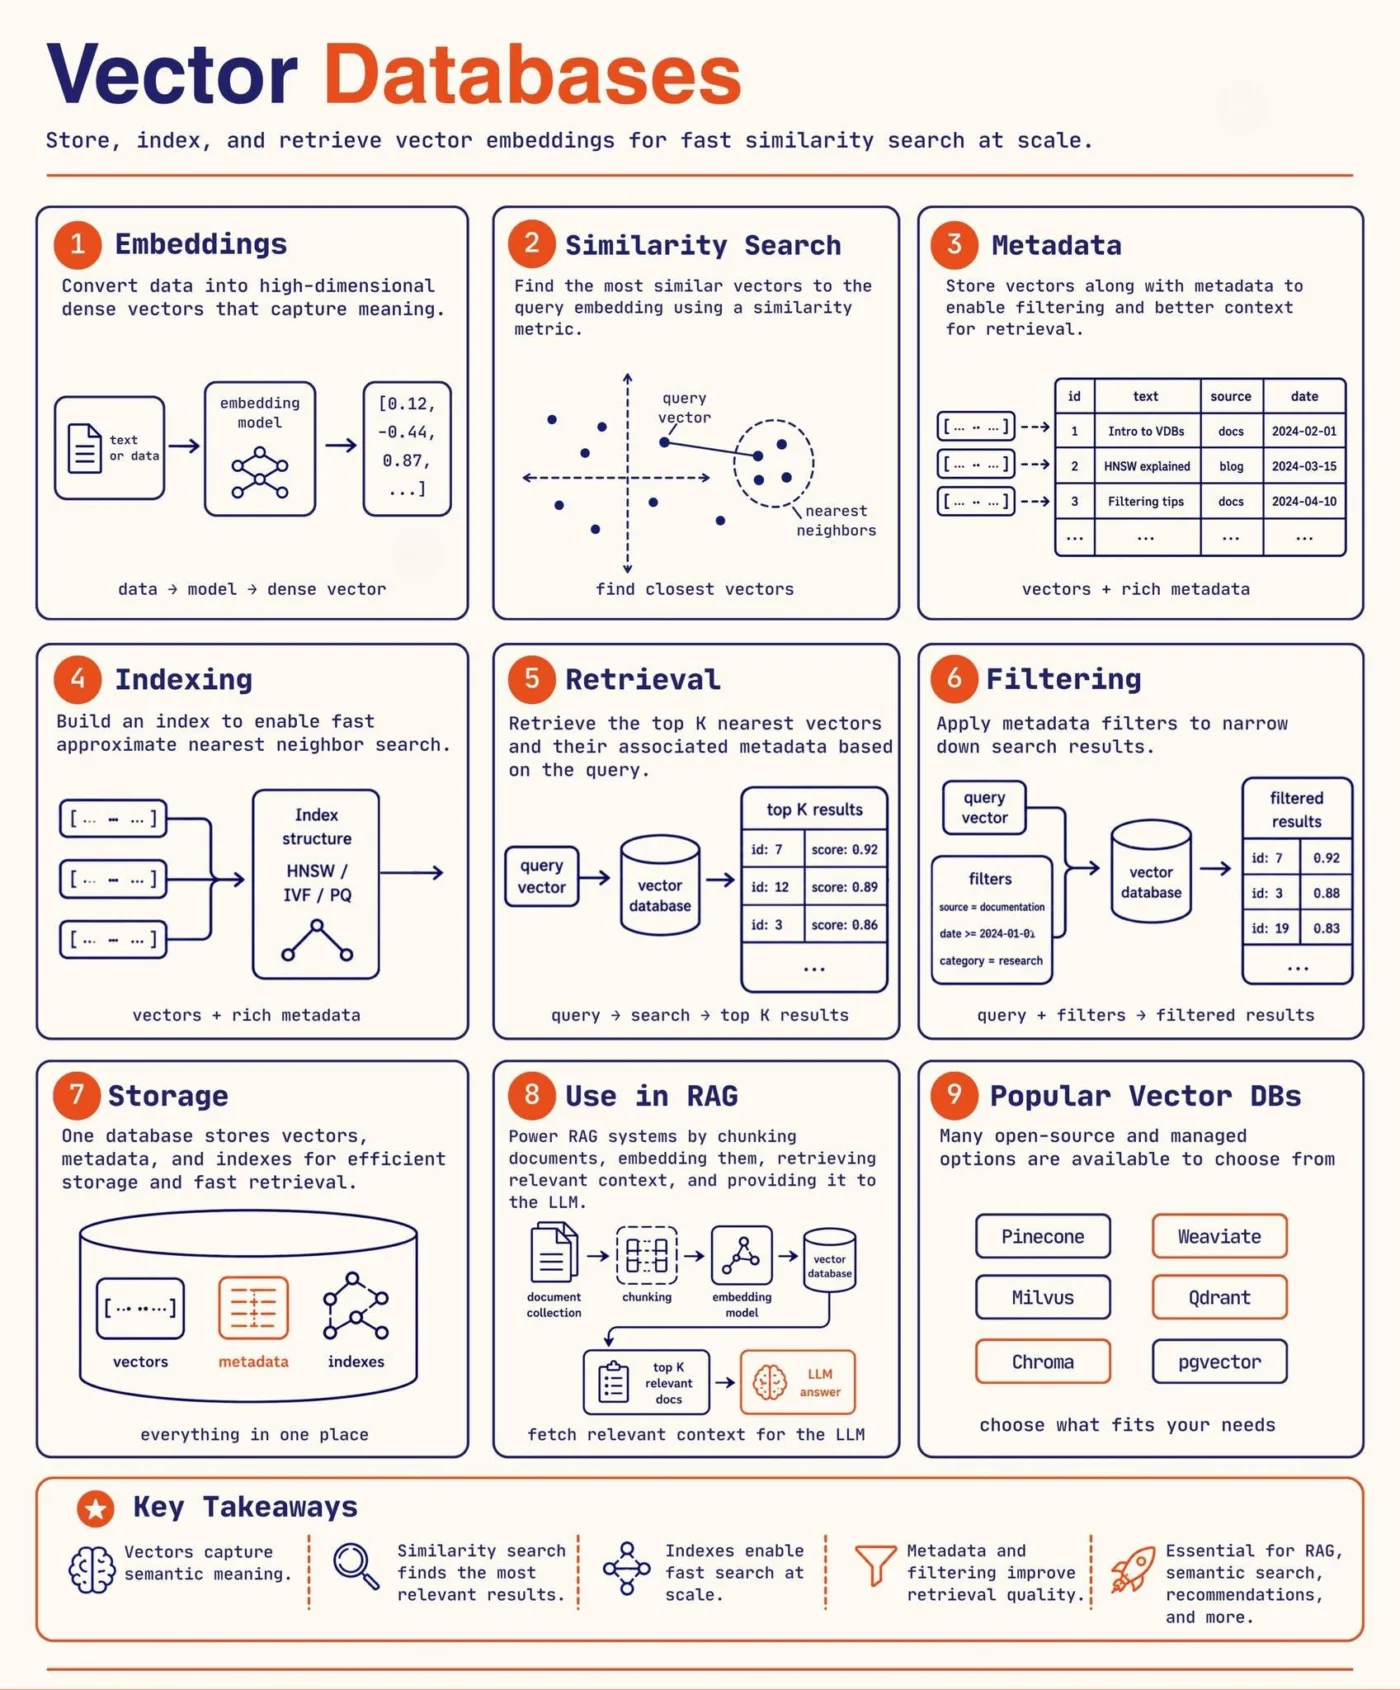
La pièce que tout le monde ignore dans un système RAG : la base vectorielle.
On parle beaucoup du LLM. Rarement de ce qui lui fournit la bonne information au bon moment.
Voici comment ça fonctionne, étape par étape :
🧠 Embeddings
Votre texte devient un vecteur dense qui capture le sens, pas juste les mots.
🔍 Recherche par similarité
La question est vectorisée à son tour, puis comparée aux vecteurs les plus proches.
🏷️ Métadonnées
Source, date, catégorie : ce qui rend un résultat réellement exploitable, pas juste "proche".
⚡ Indexation
Des structures comme HNSW, IVF ou PQ gardent la recherche rapide, même sur des millions de vecteurs.
🎯 Filtrage
Vous combinez recherche sémantique et critères stricts : source = documentation, date ≥ 2024.
📦 Stockage
Vecteurs, métadonnées et index cohabitent pour que la récupération reste efficace.
🔗 Application au RAG
Découper les documents → les vectoriser → récupérer les meilleurs extraits → les transmettre au modèle.
🛠️ Options courantes
Pinecone, Weaviate, Milvus, Qdrant, Chroma, pgvector — le choix dépend de l'échelle, du budget, du filtrage.
Cette couche compte autant que le modèle lui-même.